什么是jvm
- jvm是java程序运行时的虚拟机,java屏蔽了与操作系统相关的信息,只需要编译后的字节码,就能在任何平台运行,即 一次编译,到处运行 简单理解就是,代码不变,编译后的class文件要在虚拟机中运行,不同的平台有不同的虚拟机制,后续适配的工作是jvm做的
jvm具体干了什么
- 要回答这个问题,先要大致对jvm中代码运行的流程有一个了解:
- 首先我们最开始学习java的时候,会在计算机中写一个hello world的例子;如下
public class TestDemo {
    public static void main(String[] args) {
        System.out.println("hello world");
    }
}
- 这是一个我们能看懂的代码,要计算机能看懂就需要编译成class文件,命令就是
javac TestDemo.java
- 这样,我们的同级目录就会多一个TestDemo.class文件,后续也是执行该文件
- 接下来就是jvm中的操作了,讲述操作前,先说一下jvm中有些什么
jvm模型
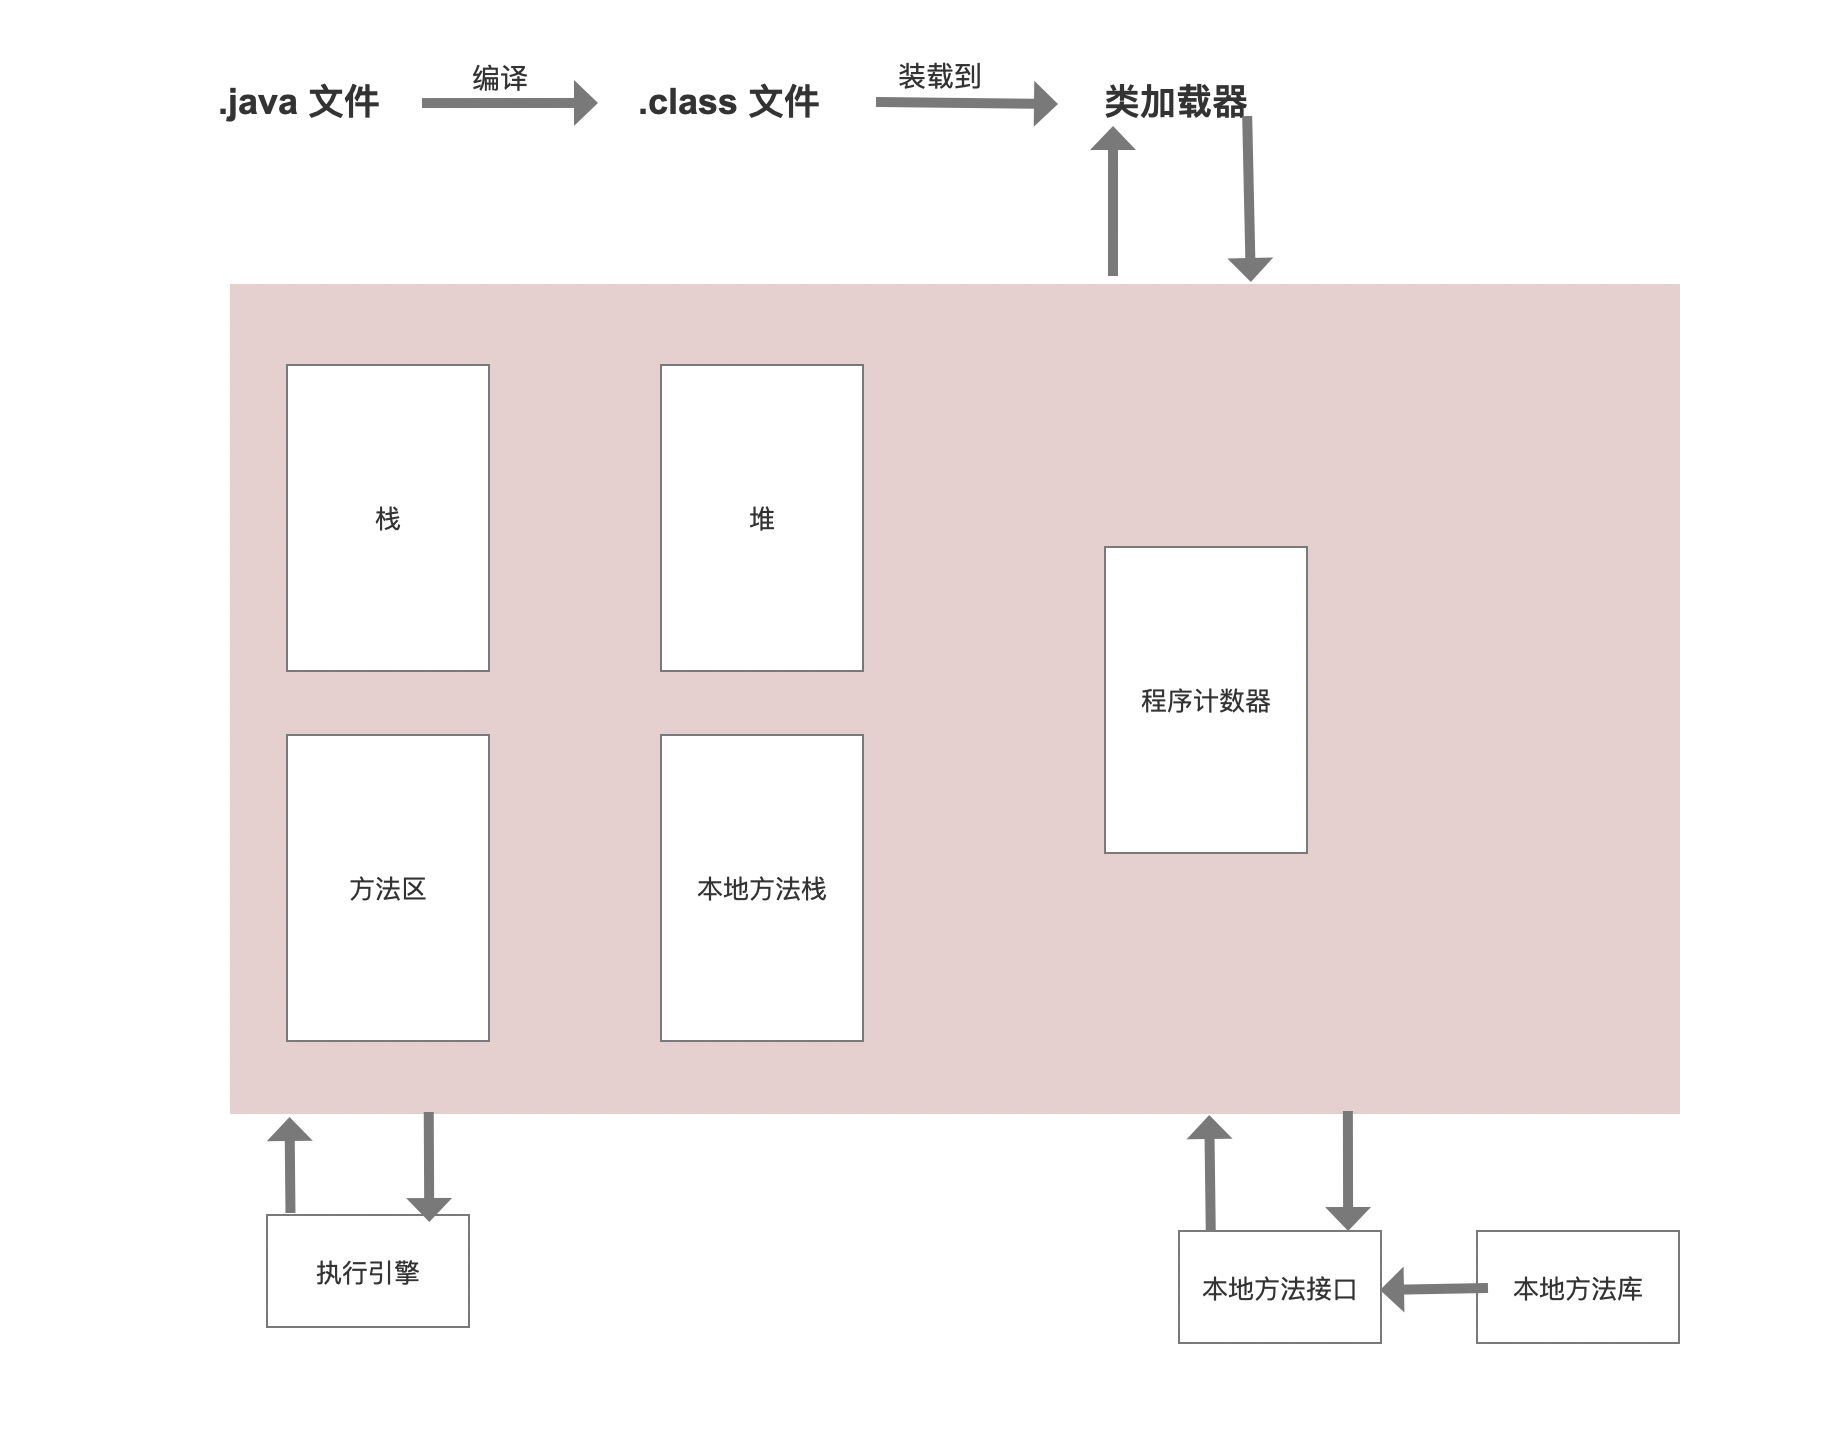
实际上,jvm的模型是很复杂的,这里只是画了比较重要的一些模块,挨个解释一下
类加载器
- 类加载器:字面意思,你写完的代码编译成字节码,然后需要jvm处理你的代码逻辑,在处理之前,需要加载你的类,具体加载的类是什么,先看下面demo
public class TestDemo {
    public static void main(String[] args) {
        TestDemo testDemo = new TestDemo();
        ClassLoader classLoader = testDemo.getClass().getClassLoader();
        String s = new String();
        ClassLoader stringClassLoader = s.getClass().getClassLoader();
        System.out.println("classLoader的类加载器:"+classLoader);
        System.out.println("classLoader的类加载器的父类:"+classLoader.getParent());
        System.out.println("stringClassLoader的类加载器:"+stringClassLoader);
    }
}
执行结果是:
classLoader的类加载器:sun.misc.Launcher$AppClassLoader@18b4aac2
classLoader的类加载器的父类:sun.misc.Launcher$ExtClassLoader@816f27d
stringClassLoader的类加载器:null
第一个的结果是app~;第二个的结果是Ext~;第三个的结果是null,什么意思?String类不加载吗?
我们需要明白一个概念:有哪些类加载器?
- 引导类加载器(BootstrapClassloader):用C++编写,是JVM自带的类加载器;负责加载Java的核心类库。(该加载器无法直接获取)
- 扩展类加载器(ExtClassloader):负责加载/jre/lib/ext目录下的jar包。
- 应用程序类加载器(AppClassloader):负责加载java -classpath或-D java.class.path所指的目录下的类与jar包。(最常用的加载器)
知道上面的概念,我们对号入座一下,平时自己写的类,如TestDemo的类加载器就是应用程序类加载器,所以是$AppClassLoader
他的父级(没有父子关系),就是拓展类加载器,具体位置如下图
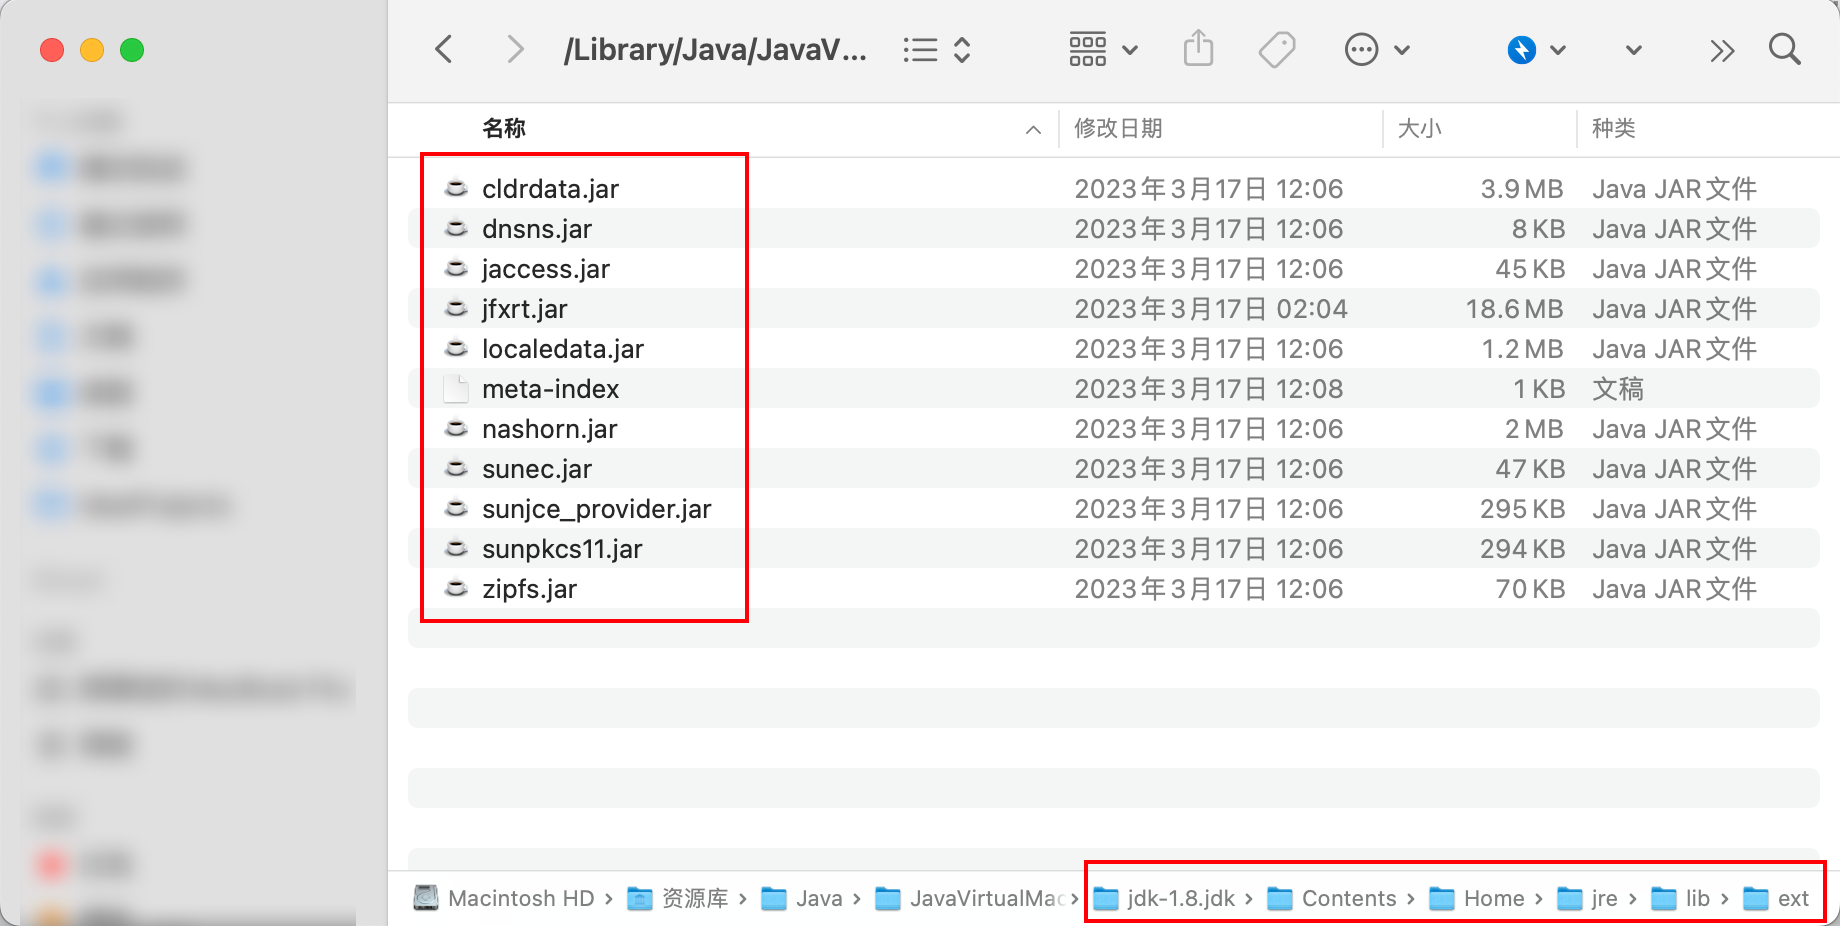
ps:想要看ext下面的类,就反编译ext路径下面的类测试一下,我随便找了一个,我们可以看看下面demo
  public static void main(String[] args) {
        ClassLoader classLoader = TimeZoneNames_af.class.getClassLoader();
        System.out.println(classLoader);
    }

//结果
sun.misc.Launcher$ExtClassLoader@53d8d10a
引导类加载器(BootstrapClassloader)就更常见了,我们用的String,Object都是里面的类
BootstrapClassloader为什么是null?
网上大部分是说:BootstrapClassLoader 最顶层的加载类,主要加载核心类库。BootstrapClassLoader是由C/C++编写的,它本身是虚拟机的一部分。 Object.class.getClassLoader()的返回值为null,因为Object类由Bootstrap ClassLoader加载,且Bootstrap ClassLoader不是一个java类,所以没有Bootstrap ClassLoader的java实例化对象,因此返回值为null。
这个我也不懂,因为没办法验证,但是我看了看源码,注释是这样的
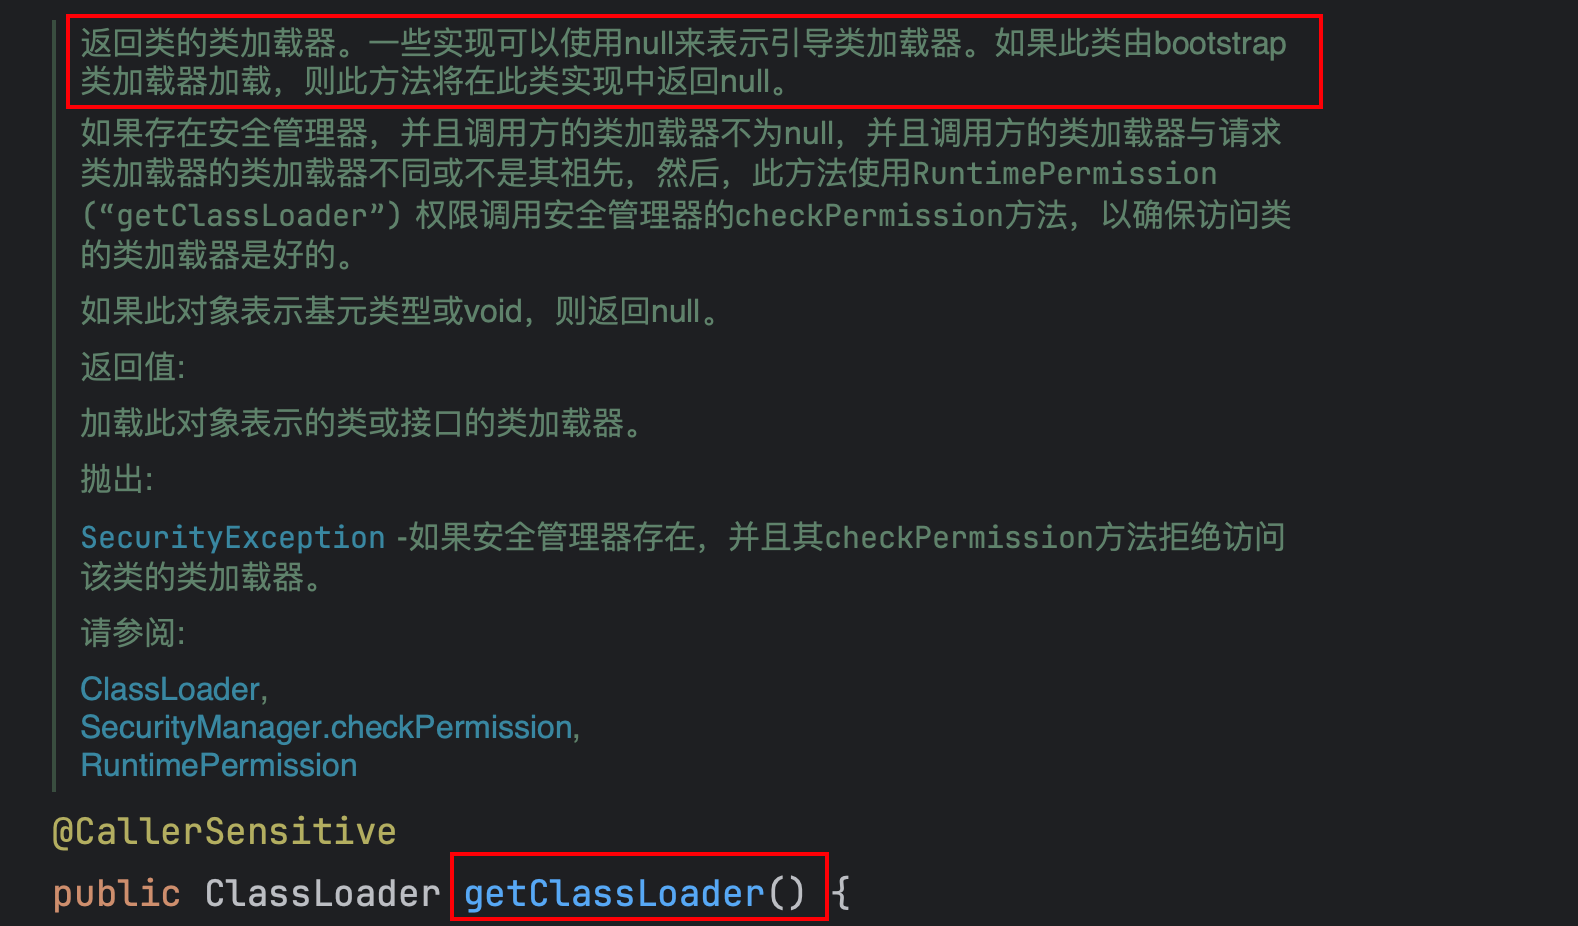
所以,当你查询是null的时候,默认就是引导类加载器加载了这个类
- 双亲委派机制:双亲委派机制百度的解释是这样的【双亲委派机制(Parent Delegation Mechanism)是Java中的一种类加载机制。在Java中,类加载器负责加载类的字节码并创建对应的Class对象。双亲委派机制是指当一个类加载器收到类加载请求时,它会先将该请求委派给它的父类加载器去尝试加载。只有当父类加载器无法加载该类时,子类加载器才会尝试加载。】
- 说人话:就是你自己写了一个类,类加载器加载这个一个类的阶段,他会在拓展类和引导类中查找有没有一样的类(全路径+类名)有的话 就加载他们的 没有的话就加载你自己的,举个栗子
package java.lang;

/**
 * @author GYQ
 */

public class String {
    public static void main(String[] args) {
        System.out.println("hello world");
    }
}
执行这个main方法会报错,具体报错如下
错误: 在类 java.lang.String 中找不到 main 方法, 请将 main 方法定义为:
   public static void main(String[] args)
否则 JavaFX 应用程序类必须扩展javafx.application.Application
这个报错第一句话是String找不到main方法,但是上面的例子中String明显是有main方法的,为什么找不到?说明类加载器加载的类不是我们自己写的String类,那么他加载的只能是java原生的String类了,java原生的String中没有main方法,所以就报错了【找不到main方法】
这里我们总结一下双亲委派机制流程:
双亲委派机制的工作流程如下:
- 类加载请求:当应用程序请求加载一个类时(例如:调用
Class.forName("SomeClass")),这个请求首先被传递给当前类加载器。 - 向上委派:当前类加载器不会立即尝试加载这个类,而是将这个请求委派给其父类加载器。父类加载器继续向上委派,直到到达引导类加载器。
- 类加载尝试:引导类加载器尝试加载这个类。如果引导类加载器找不到该类,就返回到子类加载器,子类加载器再继续尝试加载,依此类推。
- 加载成功或失败:如果某个类加载器成功加载了这个类,那么加载过程结束;如果所有的类加载器都无法加载该类,最终会抛出
ClassNotFoundException。
native,方法区
native
- native关键字包装的方法,就是java语言到达不了的方法,需要调用底层c语言的方法,比如开启线程在cpu上,比如控制鼠标移动,键盘打字,在比如控制打印机打印东西等等,这些都是java语言干不了的事 ,所以封装类的时候,会加关键字native用来和底层的硬件交互
- 线程开启
public class Demo1 {
    public static void main(String[] args) {
        new Thread("测试线程").start();
    }
}
我们都知道start开启线程,点击进去这个方法
public class Thread implements Runnable {

 public synchronized void start() {
//大致判断状态
        if (threadStatus != 0)
            throw new IllegalThreadStateException();
//加个线程组
        group.add(this);

        boolean started = false;
        try {
//关键是这一步  start0();
            start0();
            started = true;
        } finally {
            try {
                if (!started) {
                    group.threadStartFailed(this);
                }
            } catch (Throwable ignore) {

            }
        }
    }
//类中直接定义一个接口方法
    private native void start0();

}
**start0():**正常情况,类中不能写接口的,但是有native关键字,他就默认调用底层c或者c++的方法,简单来说,Java无法在cpu上开线程,只能调别的更底层语言开放的接口去调用
再举一个栗子,操作鼠标
public class Demo1 {
    public static void main(String[] args) throws AWTException {
        Robot robot = new Robot();
        robot.mouseMove(122,222);
    }
}
mouseMove这个方法点进去
   public synchronized void mouseMove(int x, int y) {
        peer.mouseMove(x, y);
        afterEvent();
    }
mouseMove这个方法点进去
    public void mouseMove(int var1, int var2) {
        this.mouseLastX = var1;
        this.mouseLastY = var2;
        this.mouseEvent(this.fDevice.getCGDisplayID(), this.mouseLastX, this.mouseLastY, this.mouseButtonsState, true, true);
    }
mouseEvent这个方法点进去
private native void mouseEvent(int var1, int var2, int var3, int var4, boolean var5, boolean var6);
底层控制鼠标也是用了别的语言的方法
这里就能提出一个新的概念JNI
JNI
JNI是Java Native Interface的缩写,通过使用 Java本地接口书写程序,可以确保代码在不同的平台上方便移植。从Java1.1开始,JNI标准成为java平台的一部分,它允许Java代码和其他语言写的代码进行交互
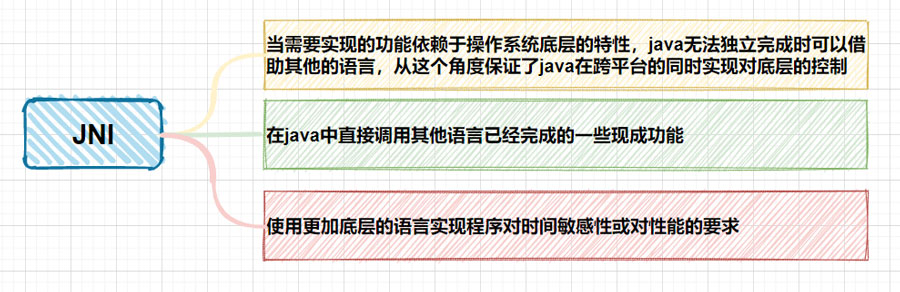
通常情况下我们一般使用jni用来调用c或c++中的代码,下面的流程来描述了native方法的调用过程:
Java Code -> JNI -> C/C++ Code
所以我们经常说java跨平台,但是我们下载jdk的时候,会区分什么:macos,linux,windows,64位,32位等,这就是jvm去调用本地方法,我们直接用java的方法,jvm会调用不同系统的底层的方法的实现
方法区
- jvm的方法区是类加载后存储类相关的信息
- 方法区的主要内容
- 类信息:
- 类的元数据(Metadata),包括类名、父类名、接口名、访问修饰符等。
- 类的结构信息,如字段、方法、构造函数等的描述。
- 常量池:
- 字符串常量、数字常量等常量池信息。
- 方法和字段的符号引用。
- 方法字节码:
- 已被加载的类的字节码,包括方法的字节码。
- 运行时常量池:
- 每个类或接口对应的常量池,包含字面量和符号引用。
- 静态变量:
- 类的静态变量,这些变量在类加载时分配并初始化。
- 即时编译器编译后的代码:
- 如果使用了即时编译器(JIT),方法区还可能存储编译后的本地代码。
- 类信息:
- 方法区的作用
- 类加载和解析:
- 当类加载器加载一个类时,类的元数据会被存储在方法区。
- 字节码执行:
- 方法的字节码存储在方法区中,JVM 在执行方法时会读取这些字节码。
- 常量池的维护:
- 方法区包含运行时常量池,用于存储类文件常量池中的符号引用,这些引用在类加载和运行时会被解析为具体的内存地址。
- 静态变量管理:
- 方法区存储类的静态变量,这些变量在类的生命周期内都存在。
- 类加载和解析:
- 方法区与堆、栈的区别
- 方法区:
- 存储类的结构信息、方法的字节码、静态变量等。
- 用于存储类元数据和方法字节码。
- 堆(Heap):
- 存储对象实例。
- 主要用于存储运行时的对象,包括实例变量和数组。
- 栈(Stack):
- 存储每个线程的栈帧,包含局部变量、操作数栈和方法返回地址等。
- 每个方法调用都会创建一个栈帧,栈帧中包含该方法执行时所需的信息。
- 方法区:
- 方法区的主要内容
栈
- 首先回顾知识点,小学二年级的时候我们就教过栈是一种先进后出的数据结构,可以把栈理解成一个开了盖的瓶子,最先丢进去的东西,最后才能掏出来
- jvm中的栈做了什么?
- 还是先看百度:Java 虚拟机栈(Java Virtual Machine Stacks),早期也叫 Java 栈。每个线程在创建的时候都会创建一个虚拟机栈,其内部保存一个个的栈帧(Stack Frame),对应着一次次 Java 方法调用,是线程私有的,生命周期和线程一致。
- 讲的比较抽象,但是有一句关键:每个线程在创建的时候都会创建一个虚拟机栈,其内部保存一个个的栈帧(Stack Frame),对应着一次次 Java 方法调用
- 简单理解就是一个栈的数据结构,在调用java代码的方法时候,把一个个方法按前后顺序放到栈中,调用完了,再一个个弹出去
public class Demo1 {
    public static void main(String[] args) {
        int a = Demo1.a();
    }

    public static int a() {
        return 30;
    }
}
- 上面的代码,最开始调用了一个main方法,然后main中调用了a方法,栈中结构如下

- 栈的基本结构知道了,那说一个我们写代码偶尔会犯的错
public class Demo1 {
    public static void main(String[] args) {
        Demo1.a();
    }

    public static void a() {
        b();
    }

    public static void b() {
        a();
    }
}
执行这个方法会报错
Exception in thread "main" java.lang.StackOverflowError
	at com.gyq.callable.Demo1.b(Demo1.java:21)
	at com.gyq.callable.Demo1.a(Demo1.java:17)
	at com.gyq.callable.Demo1.b(Demo1.java:21)
	at com.gyq.callable.Demo1.a(Demo1.java:17)
这个栈溢出的问题是怎么来的?
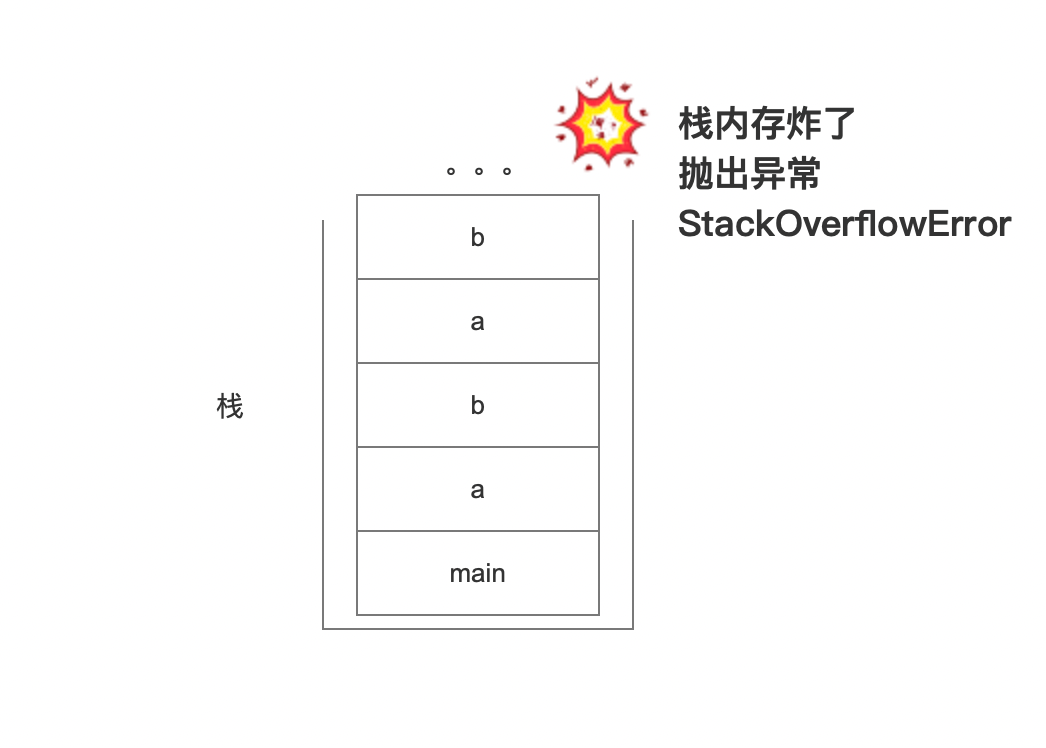
- 栈中最先进去main方法
- 然后main中调用a方法,栈中压入a方法
- a调用b方法,栈中压入b方法
- b再调用a方法,栈中再压入a方法
- 死循环压入a、b方法 栈的空间爆了,就会爆StackOverflowError
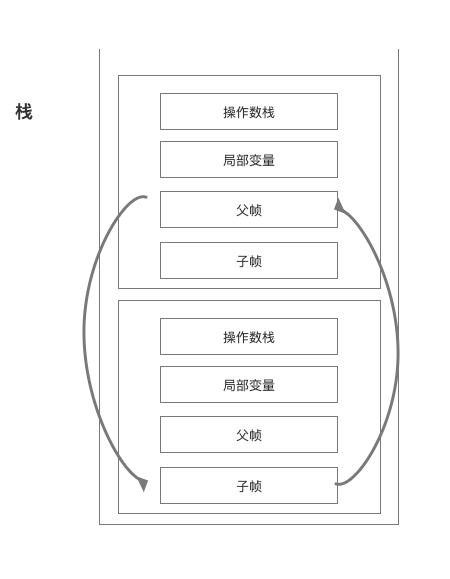
- 实际上,栈的真实结构还是要更复杂一点的,栈的每一节都是由栈帧构成的,栈帧是什么样的呢?栈帧里面包含子栈,父栈,局部变量,操作数栈
- 父栈就是初始方法栈,比如main方法中调用add方法,父栈存main;子栈是被调用方法,子栈存add
- 局部变量就是该方法中所有定义的对象
- 操作数栈是 Java 虚拟机(JVM)执行方法调用时用于记录操作数和方法返回值的栈结构
1. 举个栗子:
public class Calculator {

    public int multiply(int a, int b) {
        return a * b;
    }

    public int add(int a, int b) {
        return a + b;
    }

    public int compute() {
        int x = 2;
        int y = 3;
        int z = 4;
        int result = add(multiply(x, y), z);
        return result;
    }

    public static void main(String[] args) {
        Calculator calculator = new Calculator();
        int finalResult = calculator.compute();
        System.out.println(finalResult);
    }
}
我们来分析一下栈结构中怎么存储这段代码
在这个例子中,我们有三个方法:multiply、add 和 compute。compute 方法调用了 multiply 和 add,然后返回最终结果。
栈的详细使用过程
main方法- 调用
compute方法,创建一个Calculator实例,并调用其compute方法。
- 调用
compute方法- 初始化局部变量
x=2、y=3、z=4。 - 将
x=2和y=3推入操作数栈,并调用multiply方法。
- 初始化局部变量
- 调用
multiply方法- 创建新的栈帧,并将
x=2和y=3作为参数传递。 - 在操作数栈中进行
2 * 3计算,结果为6。 - 将结果
6推入调用者(compute方法)的操作数栈。
- 创建新的栈帧,并将
- 回到
compute方法- 将
6和z=4推入操作数栈,并调用add方法。
- 将
- 调用
add方法- 创建新的栈帧,并将
6和z=4作为参数传递。 - 在操作数栈中进行
6 + 4计算,结果为10。 - 将结果
10推入调用者(compute方法)的操作数栈。
- 创建新的栈帧,并将
- 回到
compute方法- 将结果
10赋值给局部变量result。 - 返回
result,即10,推入调用者(main方法)的操作数栈。
- 将结果
main方法- 将
finalResult=10输出到控制台。
- 将
栈帧示意图
以下是调用过程中各个栈帧和操作数栈的变化:
1. main 方法调用 compute 方法:
main 方法栈帧:
+-------------------+
| 局部变量表:         |
| calculator        |
| finalResult       |
+-------------------+
| 操作数栈:           |
|                   |
+-------------------+

2. compute 方法初始化局部变量 x, y, z:
compute 方法栈帧:
+-------------------+
| 局部变量表:       |
| x = 2             |
| y = 3             |
| z = 4             |
| result            |
+-------------------+
| 操作数栈:         |
+-------------------+

3. 调用 multiply 方法:
compute 方法栈帧:
+-------------------+
| 局部变量表:       |
| x = 2             |
| y = 3             |
| z = 4             |
| result            |
+-------------------+
| 操作数栈:         |
| 2                 |
| 3                 |
+-------------------+

multiply 方法栈帧:
+-------------------+
| 局部变量表:       |
| a = 2             |
| b = 3             |
+-------------------+
| 操作数栈:         |
+-------------------+

4. multiply 方法返回 6:
compute 方法栈帧:
+-------------------+
| 局部变量表:       |
| x = 2             |
| y = 3             |
| z = 4             |
| result            |
+-------------------+
| 操作数栈:         |
| 6                 |
+-------------------+

5. 调用 add 方法:
compute 方法栈帧:
+-------------------+
| 局部变量表:       |
| x = 2             |
| y = 3             |
| z = 4             |
| result            |
+-------------------+
| 操作数栈:         |
| 6                 |
| 4                 |
+-------------------+

add 方法栈帧:
+-------------------+
| 局部变量表:       |
| a = 6             |
| b = 4             |
+-------------------+
| 操作数栈:         |
+-------------------+

6. add 方法返回 10:
compute 方法栈帧:
+-------------------+
| 局部变量表:       |
| x = 2             |
| y = 3             |
| z = 4             |
| result = 10       |
+-------------------+
| 操作数栈:         |
+-------------------+

7. compute 方法返回 10:
main 方法栈帧:
+-------------------+
| 局部变量表:       |
| calculator        |
| finalResult = 10  |
+-------------------+
| 操作数栈:         |
+-------------------+

8. main 方法输出结果 10 到控制台:
main 方法栈帧:
+-------------------+
| 局部变量表:       |
| calculator        |
| finalResult = 10  |
+-------------------+
| 操作数栈:         |
+-------------------+
总结:知道了栈的基本概念,就能得出一些简单的理解,
- 首先,栈是不会进行垃圾回收机制的,如果栈中的一节被回收了,子帧,父帧就连不上,这个代码就崩了
- 栈里面是不会爆OOM的,最多可能爆一个StackOverflowError,那么,我们经常说的GC,OOM,jvm调优这些究竟是什么?主要讲的是堆中出现的问题
堆
写到这里,我们大概要有一点jvm逻辑框架,我们写一个java的类,编译成class文件,然后jvm中类加载器预处理,加载完正确的类,然后方法区初始化类,把类和类的方法等加载了,然后走本地方法的就JNI调用本地方法,正常的java方法,就把编译好的字节码一行一行的读,读到一个方法,就给栈中压一个方法。。。那么,堆在其中起到了什么作用呢?我们慢慢分析
首先分析一下堆中存储了什么 我们结合代码分析一下
综合理解
代码
public class MemoryDemo {
    // 静态变量,存储在方法区
    private static int staticCounter = 0;

    // 实例变量,存储在堆中
    private int instanceCounter;

    // 构造方法
    public MemoryDemo() {
        this.instanceCounter = 0;  // 初始化实例变量
    }

    // 静态方法,存储在方法区
    public static void main(String[] args) {
        // main方法的局部变量,存储在栈中
        MemoryDemo demo = new MemoryDemo();
        demo.incrementCounters();
    }

    // 实例方法,存储在方法区
    public void incrementCounters() {
        // 局部变量,存储在栈中
        int localCounter = 0;

        // 增加局部变量
        localCounter++;

        // 增加实例变量
        this.instanceCounter++;

        // 增加静态变量
        MemoryDemo.staticCounter++;

        // 打印结果
        System.out.println("Local Counter: " + localCounter);
        System.out.println("Instance Counter: " + this.instanceCounter);
        System.out.println("Static Counter: " + MemoryDemo.staticCounter);
    }
}
详细说明
- 方法区
MemoryDemo类的字节码和结构信息存储在方法区。- 静态变量
staticCounter和静态方法main、实例方法incrementCounters也存储在方法区。
- 栈
- 当
main方法开始执行时,main方法的帧被压入栈中。 main方法中的局部变量demo被存储在栈中。incrementCounters方法调用时,其局部变量localCounter也被存储在栈中。- 方法执行结束后,这些局部变量和方法帧从栈中弹出。
- 堆
- 当通过
new MemoryDemo()创建demo对象时,MemoryDemo对象被分配在堆中。 demo对象的实例变量instanceCounter存储在堆中,并在对象创建时初始化。
执行流程
- 类加载
MemoryDemo类加载后,其字节码和静态变量staticCounter存储在方法区。
- 方法调用
main方法被调用,main方法帧被压入栈中,局部变量demo存储在栈中。
- 对象创建
new MemoryDemo()调用构造方法,创建MemoryDemo对象,分配在堆中,实例变量instanceCounter初始化为0。
- 方法调用与局部变量
incrementCounters方法被调用,方法帧压入栈中,局部变量localCounter在栈中初始化为0。localCounter、this.instanceCounter、MemoryDemo.staticCounter分别递增。
- 打印结果
incrementCounters方法结束,方法帧和局部变量从栈中弹出。
由上面可见 堆中存储的是:
- 堆是JVM中用于存储对象和数组的区域。所有通过
new关键字创建的对象和数组都在堆中分配内存。堆是JVM内存模型中最大的一部分,主要用于存储程序运行时动态生成的数据。 - 即 方法中new的对象,以及对象中有定义的变量(不是静态变量,静态变量要进入方法区)
一个常见的堆的问题
我们经常听过一个问题OOM,这是个什么东西,OOM,全称:OutOfMemoryError**,我们理解一下,内存溢出,什么溢出,总不可能是栈溢出,因为栈溢出之前已经理解了,栈中东西对太多直接会爆StackOverflowError**,OOM是把内存撑爆了,那就只有堆能创造这个报错,那么我们就可以人为模拟一下这个错误,刚才讲过,方法中的基本变量是存到栈的局部变量表中的,要给堆中塞东西,就要用到引用变量了
public class Test {
    public static void main(String[] args) {
        StringBuilder str = new StringBuilder();
        while (true) {
            str.append(new Random().nextInt(99999999));
        }
    }
}


//结果
Exception in thread "main" java.lang.OutOfMemoryError: Java heap space
	at java.util.Arrays.copyOf(Arrays.java:3332)
	at java.lang.AbstractStringBuilder.ensureCapacityInternal(AbstractStringBuilder.java:124)
	at java.lang.AbstractStringBuilder.append(AbstractStringBuilder.java:674)
	at java.lang.StringBuilder.append(StringBuilder.java:214)
	at com.gyq.openAi.Test.main(Test.java:19)
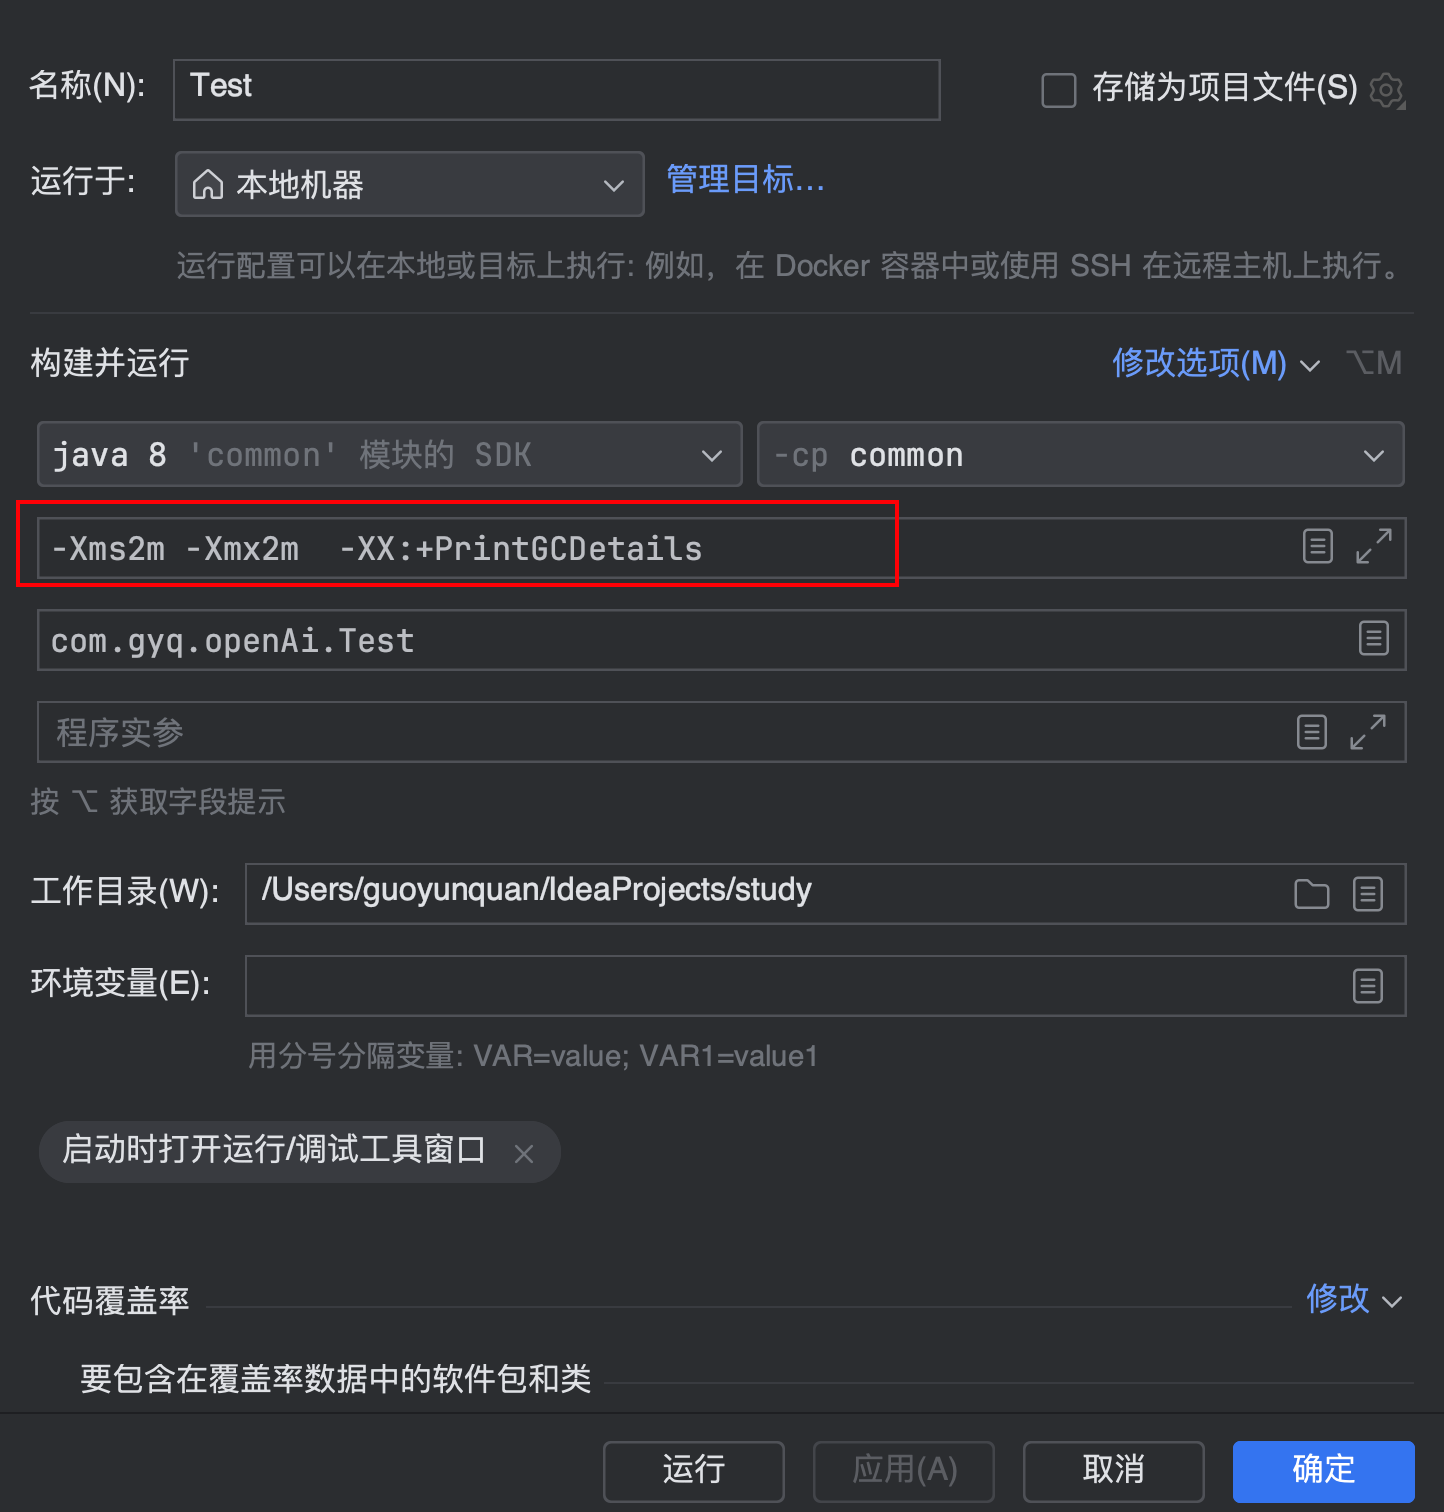
调用这个方法,最好将默认堆内存和最大堆内存设置的小一点,要不然复现时间长
垃圾回收机制
- 堆中区分区块
- 刚才我们了解了堆中存放的对象是什么,现在我们了解一下堆中内存的分区
标记清除法
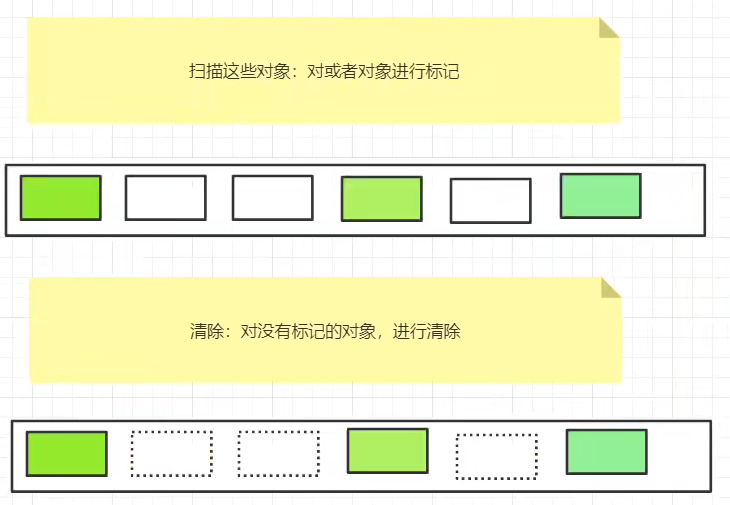
- 优点:不需要额外的空间。
- 缺点:两次扫描,严重浪费时间,会产生内存碎片。
标记清除压缩法
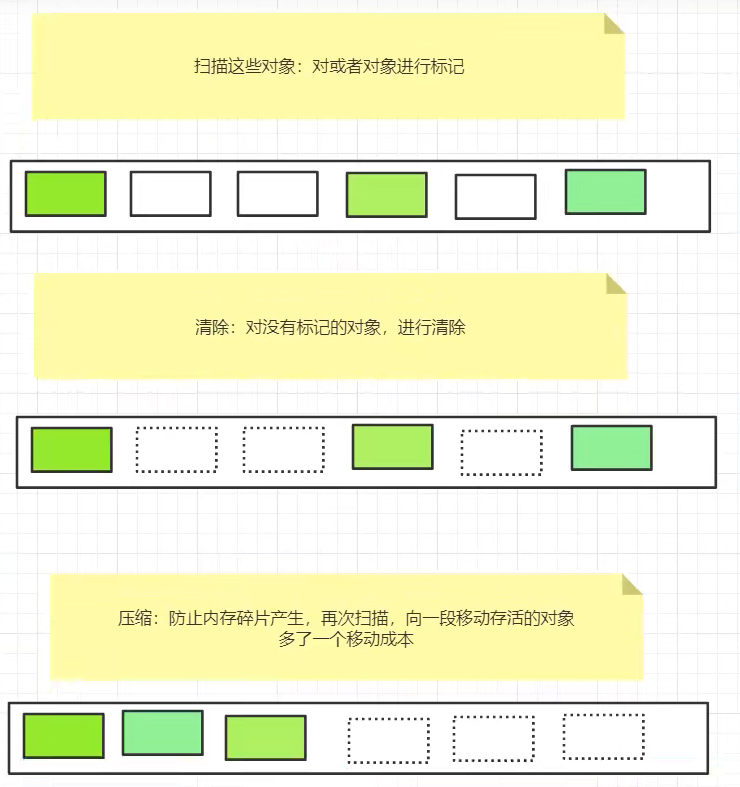
标记清除压缩(改进)
可以进行多次标记清除后,再进行一次压缩。
复制算法
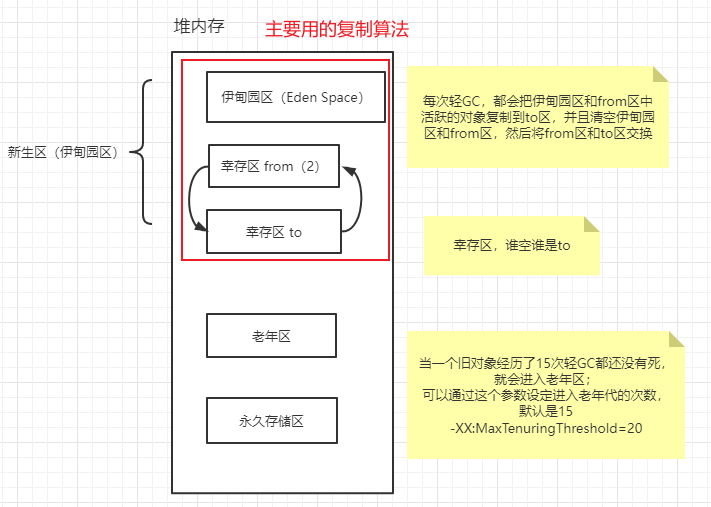
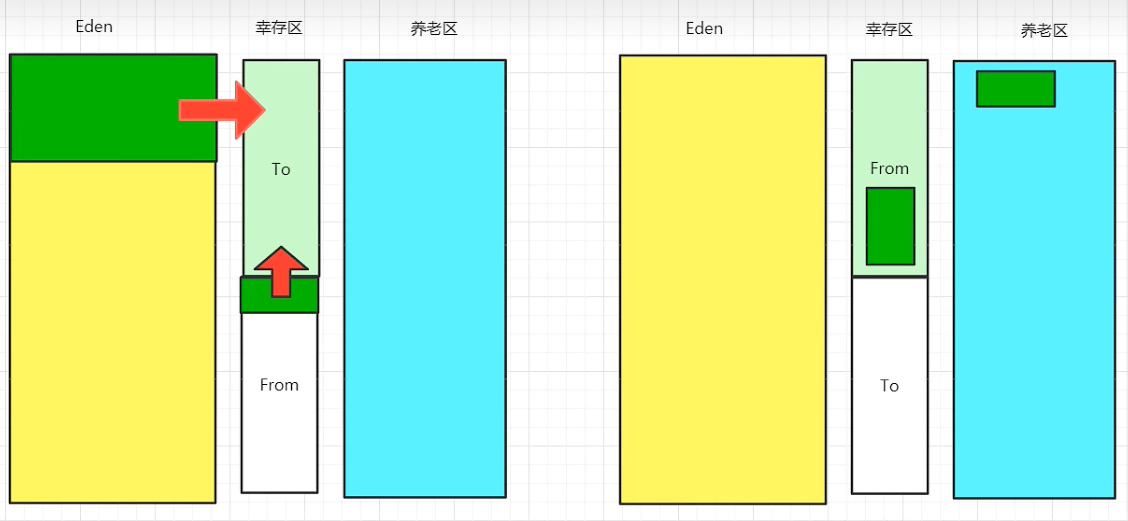
- 好处:没有内存的碎片。
- 坏处:浪费了内存空间(多了一半空间to永远是空)。假设对象100%存活(极端情况),不适合使用复制算法。
使用场景
复制算法最佳使用场景:对象存活度较低的时候(新生区)
GC算法总结
- 时间复杂度:复制算法>标记清除算法>标记压缩算法
- 内存整齐度:复制算法=标记压缩算法>标记清除算法
- 内存利用率:标记压缩算法=标记清除算法>复制算法
思考一个问题:难道没有最优算法吗?
答案:没有,没有最好的算法,只有最合适的算法—>GC:分代收集算法
年轻代:
- 存活率低
- 复制算法
老年代:
- 区域大:存活率高
- 标记清除(内存碎片不是太多)+标记压缩混合实现